 José Zegarra
Table of Contents
Resumen
AMD presentó una nueva entrega de Ryzen AI Halo, su plataforma compacta para desarrollar y ejecutar inteligencia artificial local. La configuración con Ryzen AI Max+ PRO 495 ofrece hasta 192 GB de memoria unificada, con hasta 160 GB asignables a gráficos dentro de ese total.
La memoria unificada abre espacio para modelos grandes y flujos multiagente, con un desempeño que debe evaluarse sobre tareas completas. AMD presentó una nueva versión de Ryzen AI Halo, su plataforma compacta para desarrollar y ejecutar IA local. La configuración con Ryzen AI Max+ PRO 495 incorpora hasta 192 GB de memoria unificada. Permite explorar modelos grandes y flujos multiagente, aunque su utilidad depende del software, la cuantización y el rendimiento real.
Claves de la noticia
- Ryzen AI Halo está orientado al desarrollo de IA personal y computación agéntica local.
- La configuración con Ryzen AI Max+ PRO 495 ofrece hasta 192 GB de memoria unificada.
- Hasta 160 GB pueden asignarse a gráficos, según AMD.
- El soporte anunciado para modelos de 300,000 millones de parámetros contempla cuantización a cuatro bits.
- Los precios comunicados son referencias en dólares y no acreditan disponibilidad ni precio final en Perú.
Lima, Perú, 16 de octubre de 2026.— La ejecución local de la inteligencia artificial está ampliando las opciones de los desarrolladores que necesitan experimentar con modelos, trabajar con sus propios datos y coordinar herramientas desde el escritorio. El desafío combina capacidad de memoria, procesamiento y compatibilidad del entorno de software.
AMD anunció el pasado 12 de octubre una nueva entrega de Ryzen AI Halo, impulsada por Ryzen AI Max+ PRO 495. La comunicación contempla configuraciones de hasta 192 GB de memoria unificada y soporte para modelos de 300,000 millones de parámetros. La documentación oficial precisa que esa capacidad corresponde a modelos optimizados para ocupar menos memoria, mediante una representación numérica de cuatro bits. Fuente: amd.com
Para las organizaciones, la oportunidad consiste en evaluar qué tareas pueden ejecutarse localmente con calidad y tiempos adecuados. Alojar un modelo grande es una condición técnica; convertirlo en una herramienta útil requiere medir el flujo de trabajo completo.
Un desarrollador quiere analizar documentos, coordinar herramientas y preparar un resultado sin enviar necesariamente toda la información a un servicio remoto. El reto aparece cuando modelos, aplicaciones y contexto compiten por la memoria disponible. La nueva generación de equipos para IA local busca ampliar ese margen y acercar más etapas del trabajo al escritorio.
Por qué esta tendencia gana relevancia
Los flujos agénticos reúnen actividades diferentes: interpretar instrucciones, consultar archivos, utilizar herramientas y comprobar resultados. Su ejecución necesita recursos para el modelo y para las aplicaciones que participan en la tarea.
La IA local ofrece una alternativa para determinados escenarios de desarrollo y operación. Permite decidir dónde se realiza el procesamiento, pero también exige administrar modelos, actualizaciones y seguridad del equipo. La elección entre ejecución local, nube o una combinación de ambas debe responder a la carga de trabajo, los costos y las necesidades de control.
Más memoria para desarrollar IA desde el escritorio
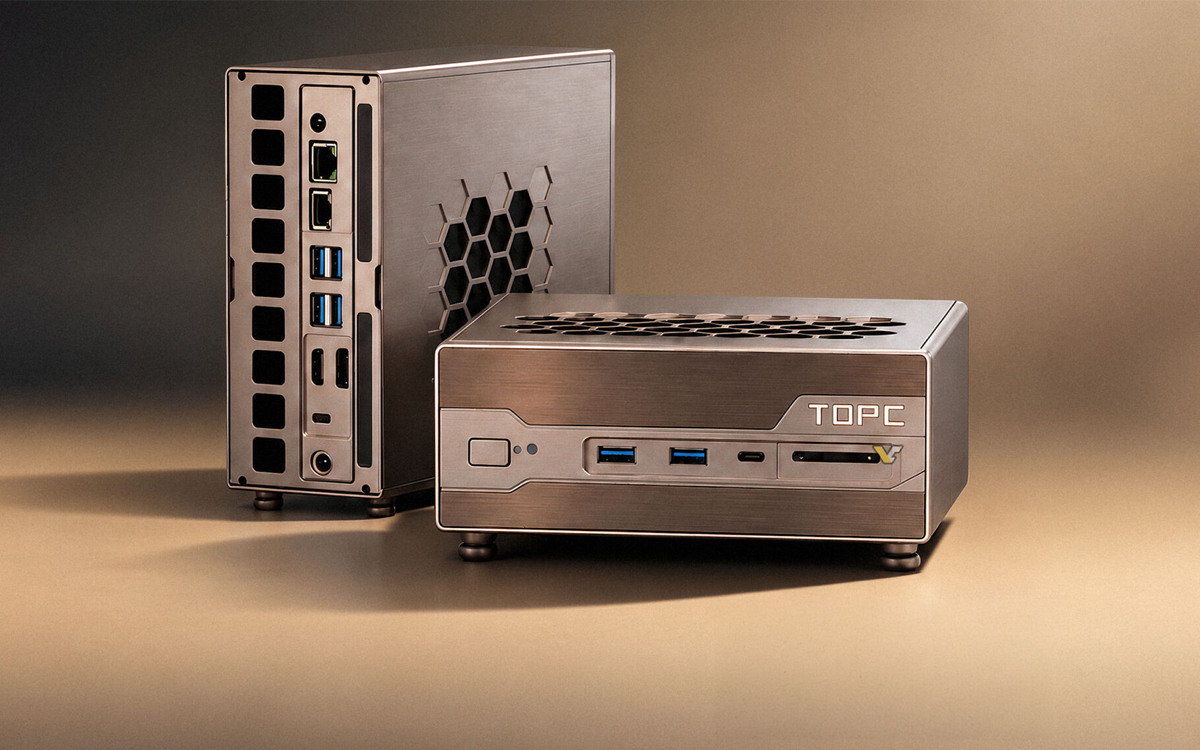
AMD (NASDAQ: AMD) amplía Ryzen AI Halo con una configuración basada en Ryzen AI Max+ PRO 495, dirigida a desarrolladores y usuarios que trabajan con modelos y aplicaciones de IA local.
La comunicación distribuida por la compañía presenta dos referencias principales:
| Configuración de Ryzen AI Halo | Memoria unificada anunciada | Capacidad de modelos comunicada | Precio inicial informado |
|---|---|---|---|
| Ryzen AI Max+ 395 | Hasta 128 GB | Hasta 200,000 millones de parámetros* | US$3.999,99 |
| Ryzen AI Max+ PRO 495 | Hasta 192 GB | Hasta 300,000 millones de parámetros* | US$7.299,99 |
Las cifras describen capacidad anunciada, no velocidad garantizada. Para la configuración PRO 495, AMD especifica cuantización a cuatro bits. El correo no detalla las condiciones correspondientes al límite de 200.000 millones de parámetros.
Los valores proceden de la comunicación comercial y no constituyen una cotización peruana. Impuestos, transporte, configuración y condiciones del canal deben verificarse antes de comparar inversiones.
En el modelo superior, AMD señala que pueden asignarse hasta 160 GB a gráficos. Esa asignación forma parte de la memoria unificada: no debe sumarse a los 192 GB como si fuera una capacidad adicional.
La tecnología detrás: memoria unificada y modelos cuantizados
Compartir memoria cambia las posibilidades de trabajo
La memoria unificada permite que distintos componentes de procesamiento utilicen un conjunto compartido de memoria. Para el desarrollo de IA, su relevancia está en el espacio disponible para mantener modelos y datos de trabajo.
Puede compararse con una mesa de trabajo: ampliar su superficie permite tener más materiales al alcance. La velocidad con la que se completa una tarea depende, además, de las herramientas y de cómo se organiza el proceso.
Por eso, la capacidad máxima es solo una parte de la evaluación. Importan también el rendimiento del software, la cantidad de procesos simultáneos y la memoria necesaria para el contexto de cada sesión.
Qué significa ejecutar un modelo de 300,000 millones de parámetros
Los parámetros son valores aprendidos durante el entrenamiento de un modelo. Su cantidad ayuda a describir su escala, pero no determina por sí sola su calidad para una tarea.
La cuantización reduce la precisión numérica con la que se representan determinados valores, disminuyendo las necesidades de memoria. El efecto sobre calidad y rendimiento depende del modelo y de la implementación.
Como cálculo ilustrativo, representar 300,000 millones de parámetros a cuatro bits requiere aproximadamente 150 GB decimales solo para esos valores. A ello se añaden estructuras auxiliares, contexto y otros recursos de ejecución. No es una medición del consumo real de un modelo específico.
La pregunta de compra, por tanto, debe ir más allá de si el modelo cabe: ¿responde con calidad suficiente y dentro del tiempo que necesita el usuario?
Cómo funciona en la práctica: agentes, herramientas y contexto
Un flujo multiagente puede distribuir tareas entre componentes especializados. Uno organiza información, otro genera un borrador y otro comprueba determinados criterios.
Esto no significa que cada agente necesite un modelo distinto. Varios agentes pueden utilizar el mismo modelo con instrucciones y herramientas diferentes. La carga dependerá de la arquitectura y del grado de concurrencia.
Como escenario ilustrativo, un equipo de desarrollo podría probar un asistente documental local que consulte archivos autorizados, prepare una síntesis y señale las referencias utilizadas. Después podría incorporar una etapa de revisión.
Para evaluar el resultado convendría medir:
- Si las respuestas corresponden a los documentos.
- Cuánto tarda en completarse la tarea.
- Cómo cambia el rendimiento con varios usuarios o procesos.
- Qué errores requieren intervención humana.
- Qué comunicaciones externas realiza el flujo.
Ejecutar el modelo localmente no garantiza que todas las herramientas conectadas funcionen sin internet. La cobertura local debe comprobarse de extremo a extremo.
Un ecosistema con formatos diferentes
La comunicación de AMD menciona equipos de HP, Framework y GMKtec dentro del ecosistema de procesadores Ryzen AI Max. Entre ellos figura el GMKtec EVO-X5 Pro, cuya página oficial identifica el procesador Ryzen AI Max+ PRO 495. Fuente: gmktec.com
Estas alternativas deben evaluarse por configuración concreta. Compartir una familia de procesadores no implica igual capacidad de memoria, refrigeración, rendimiento sostenido o soporte.
Para una organización, el formato también importa. Un escritorio compacto y una estación móvil pueden atender necesidades distintas de movilidad, expansión y mantenimiento. La comparación debe partir del trabajo que realizará el equipo.
Cómo evaluar un sistema de IA local
La prueba más útil reproduce una tarea real con condiciones documentadas. Comparar modelos, precisiones o contextos diferentes puede producir resultados que no responden a la misma pregunta.
| Dimensión | Qué conviene medir | Para qué sirve |
|---|---|---|
| Calidad | Exactitud y correcciones necesarias | Determinar si el resultado es utilizable |
| Tiempo inicial | Espera hasta la primera respuesta | Evaluar la interacción |
| Generación | Tokens por segundo bajo condiciones equivalentes | Comparar una parte del desempeño |
| Tarea completa | Tiempo hasta obtener un entregable validado | Medir utilidad operativa |
| Memoria | Consumo con modelo, contexto y aplicaciones | Detectar límites prácticos |
| Concurrencia | Comportamiento con varias tareas | Comprobar capacidad compartida |
| Operación | Energía, estabilidad y administración | Estimar costos y mantenimiento |
Estos son criterios editoriales de evaluación, no resultados de un benchmark de IT/USERS® Magazine.
El correo menciona un documento titulado «Cómo recomienda AMD evaluar los sistemas de IA local», pero no se proporcionó su contenido para este análisis. Los criterios anteriores no se presentan como una reproducción de ese material.
Relación con la IA empresarial: control y costo total
El procesamiento local puede ofrecer mayor control sobre dónde se ejecutan determinadas tareas. Su adopción requiere acompañar el hardware con gestión de accesos, protección de archivos y mantenimiento.
También modifica la estructura de costos. Frente a un servicio contratado por uso, un equipo local incorpora inversión inicial y responsabilidades operativas. Su conveniencia dependerá de cuánto se utilice y de las tareas que resuelva.
No corresponde asumir que la ejecución local siempre será más económica o tendrá menor impacto ambiental. Es necesario comparar energía, utilización del equipo, vida útil y resultados obtenidos.
Una arquitectura híbrida puede reservar trabajo local para ciertas cargas y recurrir a servicios remotos cuando se justifique. Esa distribución debe responder a criterios explícitos de datos, calidad y costo.
¿Por qué es importante?
Para un CIO, CTO o líder de desarrollo, la IA local amplía opciones de procesamiento y control. La decisión exige comprobar compatibilidad, calidad, tiempos y costo total. La memoria disponible permite explorar modelos mayores, pero el valor empresarial aparece cuando el equipo completa tareas útiles de forma estable y verificable.
Visión Estratégica
La evolución de equipos compactos con mayor memoria acerca capacidades de IA a desarrolladores, laboratorios y áreas de innovación. La tendencia amplía la posibilidad de experimentar localmente, aunque su adopción dependerá del equilibrio entre hardware, software y necesidades concretas.
Para el Perú, una ruta razonable es seleccionar casos delimitados y probarlos antes de comprometer una renovación amplia. La evaluación debe incluir precio final, disponibilidad, garantía y capacidad técnica para administrar el entorno.
En Latinoamérica, las diferencias de presupuesto y soporte aconsejan comparar configuraciones completas. La mayor capacidad de memoria puede resultar valiosa cuando elimina una limitación real del proyecto.
Desde una perspectiva editorial, el criterio central debe ser el trabajo terminado: calidad, tiempo y esfuerzo de revisión. Esa evidencia permitirá decidir qué conviene ejecutar en el escritorio y qué recursos adicionales requiere cada organización.
Datos citables
- 12 de octubre de 2026: fecha del anuncio oficial de la nueva entrega de Ryzen AI Halo.
- Hasta 192 GB: memoria unificada anunciada para la configuración Ryzen AI Max+ PRO 495.
- Hasta 160 GB: porción asignable a gráficos dentro de esa memoria, según AMD.
- 300.000 millones de parámetros: escala de modelos anunciada para PRO 495, con cuantización a cuatro bits.
- Hasta 128 GB: memoria unificada comunicada para Ryzen AI Halo con Ryzen AI Max+ 395.
- US$3.999,99: precio inicial informado para la configuración con Ryzen AI Max+ 395.
- US$7.299,99: precio inicial informado para la configuración con Ryzen AI Max+ PRO 495.
Knowledge Layer — Glosario
IA local
Ejecución de modelos y tareas de inteligencia artificial en un equipo próximo al usuario, sin depender necesariamente de procesamiento remoto.
Memoria unificada
Conjunto de memoria compartido por distintos componentes de procesamiento del sistema.
Parámetros
Valores aprendidos durante el entrenamiento que forman parte de la representación interna de un modelo.
Cuantización
Técnica que reduce la precisión numérica utilizada para representar valores y puede disminuir sus necesidades de memoria.
Inferencia
Ejecución de un modelo ya entrenado para producir resultados a partir de una entrada.
Contexto
Información que el modelo utiliza durante una interacción, incluidos instrucciones y materiales proporcionados.
Flujo multiagente
Organización de tareas entre varios agentes que utilizan modelos, herramientas e instrucciones para completar un proceso.
Benchmark
Prueba realizada bajo condiciones definidas para evaluar aspectos como rendimiento, calidad o consumo.
Tu Opinión Nos Importa 🗣️
Me interesa conocer qué tarea de tu organización llevarías primero a un equipo de IA local. ¿Tu principal necesidad es controlar los datos, experimentar con modelos o reducir tiempos de trabajo? ¿Qué resultado exigirías comprobar antes de invertir en una plataforma de este tipo?
Te invito a compartir tus experiencias y preguntas en los comentarios con nuestros hashtags #ItusersAwards2026 y #superfan.
Apoya al Periodismo Independiente

¿Te sirvió en algo este contenido?, ayúdanos a combatir la Desinformación, dona desde S/ 1.00 a nuestro PLIN 943-438-457